Concordancia entre modelos de lenguaje grande y ortodoncistas en la evaluación ortodóntica basada en fotografías
Resumen ejecutivo
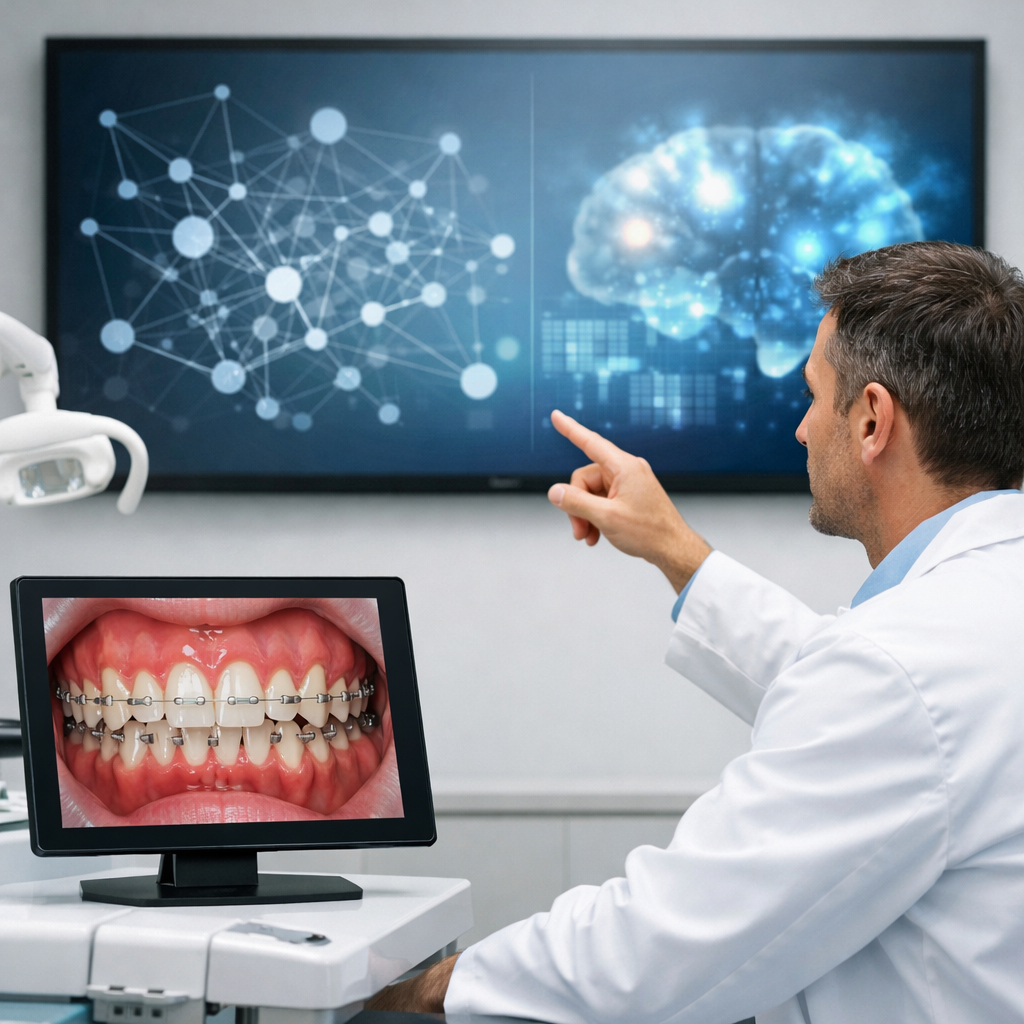
Este estudio investiga la precisión clínica de los sistemas basados en modelos de lenguaje grande (LLM) en la evaluación ortodóntica utilizando solo fotografías intraorales, comparando sus resultados con los de ortodoncistas expertos.
Qué problema aborda
El creciente uso de herramientas digitales y de inteligencia artificial (IA) en la odontología ha generado interés en su aplicación para la educación de pacientes y la orientación clínica preliminar. Sin embargo, la consistencia clínica de las evaluaciones ortodónticas realizadas por sistemas de LLM utilizando únicamente fotografías intraorales no está clara.
Qué hicieron los autores
Los autores llevaron a cabo un estudio comparativo ciego que incluyó a 104 pacientes de 12 años o más que se sometieron a una evaluación ortodóntica. Para cada caso, se enviaron tres fotografías intraorales estandarizadas y datos demográficos básicos a dos sistemas de LLM (ChatGPT-4o y Grok 4.1) utilizando un mensaje estandarizado. Las respuestas a cinco preguntas clínicas fueron evaluadas de forma independiente por tres ortodoncistas expertos mediante una escala Likert de 5 puntos. Se calcularon las puntuaciones de consenso promediando las calificaciones de los tres evaluadores, y se realizaron comparaciones intersistemas utilizando la prueba de rango con signo de Wilcoxon.
Qué encontraron
Los resultados mostraron que las calificaciones promedio fueron generalmente iguales o superiores a 3, lo que indica una aceptabilidad clínica moderada. Se observó que ChatGPT-4o recibió calificaciones significativamente más altas para el enfoque de tratamiento recomendado en pacientes con Clase Dental I. En el subgrupo de 12 a 15 años, también recibió calificaciones más altas para la recomendación de tratamiento, aunque la significancia estadística solo se mantuvo después de la corrección por la tasa de descubrimiento falso (FDR) y no tras el ajuste de Bonferroni. No se encontraron diferencias significativas en la mayoría de los otros parámetros evaluados, especialmente en la clasificación de maloclusión.
Limitaciones
El texto disponible no detalla las limitaciones específicas del estudio.
Lectura final
Los hallazgos sugieren que los sistemas basados en LLM pueden ofrecer resultados clínicamente aceptables en ciertas áreas de evaluación ortodóntica cuando se basan exclusivamente en fotografías intraorales. Sin embargo, la variabilidad en tareas de toma de decisiones complejas, como la planificación del tratamiento, indica que estos sistemas deben ser utilizados como herramientas de apoyo bajo supervisión profesional, y no como tomadores de decisiones clínicas independientes.
Sigue leyendo
Lectura clínica
Información editorial dirigida a profesionales de la salud. No sustituye la evaluación clínica, las guías vigentes ni el juicio médico.
Clasificación editorial automática
Fuente original
IA en odontología: qué funciona hoy y qué preguntar
Leer la guía →También en el radar
 Inteligencia artificial
Votantes piensan que los políticos no escuchan. ¿Podría ayudar la IA?
19 de octubre de 2026 Inteligencia artificial
Infraestructura para startups asistidas por inteligencia artificial de Bill Gross
19 de octubre de 2026 Inteligencia artificial
Google Gemini 4 logra vencer a Minecraft sin intervención humana
19 de octubre de 2026 Inteligencia artificial
Propuesta secreta de Anthropic para una ley de "kill switch" de IA desata controversia
19 de octubre de 2026
¿Quieres más contexto?
Cada semana seleccionamos las señales de IA que importan, con foco en medicina.
Únete a la lista de RADAR
Te avisaremos cuando publiquemos el primer boletín y recibirás una selección breve de las señales de IA que realmente importan.