
Correctitud, perjuicio y diversidad de grandes modelos de lenguaje para la asistencia en la preparación de colonoscopias: estudio de evaluación comparativa
Resumen ejecutivo
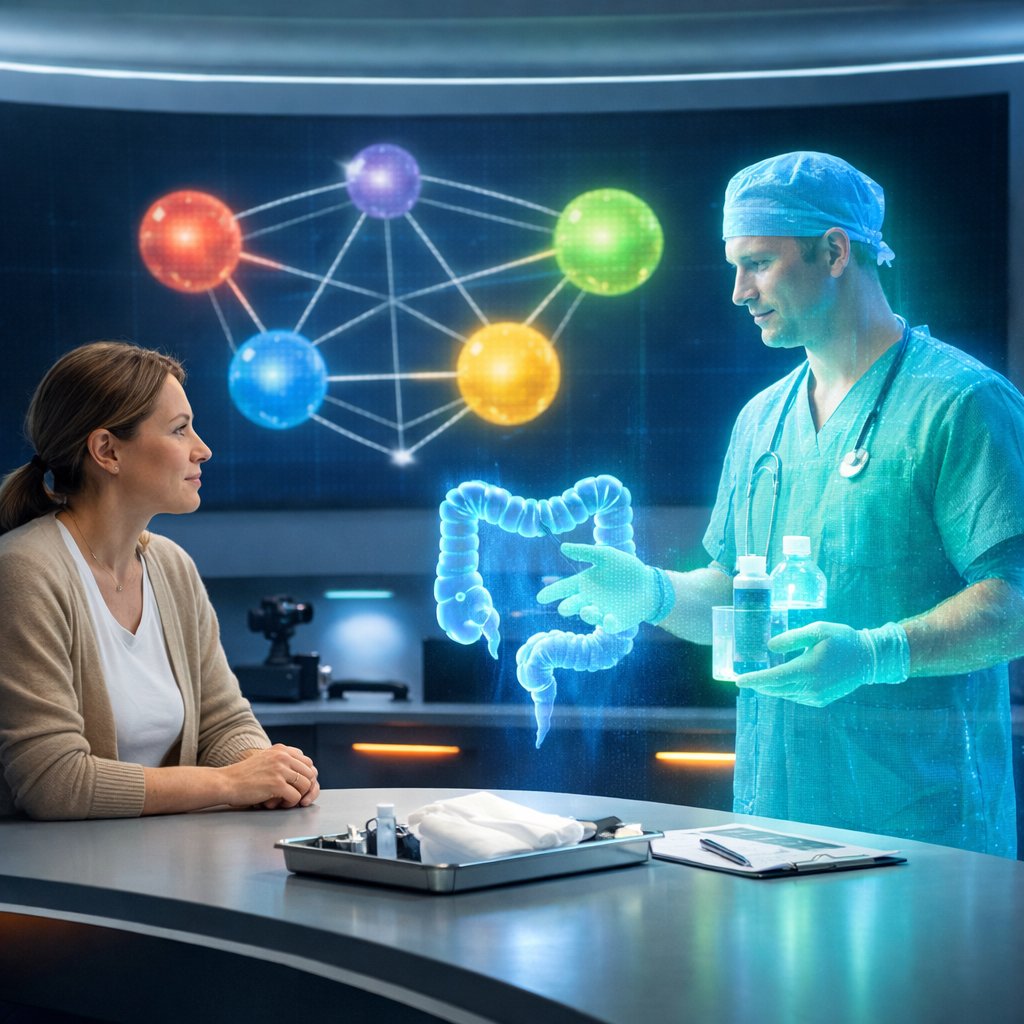
Un estudio reciente evalúa la capacidad de cinco modelos de lenguaje avanzado para generar diálogos que ayuden a los pacientes a prepararse para una colonoscopia. Aunque muestran un potencial significativo, los modelos todavía no son lo suficientemente confiables para un uso independiente en entornos de atención al paciente, dada la existencia de errores perjudiciales y la necesidad de una mejor adherencia a las instrucciones.
Contexto
El cáncer colorrectal es una de las principales causas de muerte por cáncer en Estados Unidos. La colonoscopia se considera el estándar de oro para la detección temprana y la prevención de esta enfermedad. Sin embargo, muchos procedimientos se retrasan debido a una preparación intestinal inadecuada, que a menudo se origina en la dificultad de los pacientes para entender y seguir las instrucciones escritas sobre la preparación. Aunque se han implementado aplicaciones de recordatorio y videos instructivos, la mejora en la adherencia ha sido modesta, ya que no pueden responder a preguntas específicas de los pacientes.
Qué aporta esta novedad
Este estudio se centra en la evaluación de cinco modelos de lenguaje avanzados (LLMs), incluyendo GPT-5.1 y GPT-4.1 de OpenAI, Llama 3.3 70B de Meta, y Mistral's Large-2411, para generar 250 diálogos entre pacientes y asistentes de IA sobre la preparación para la colonoscopia. Utilizando un enfoque de múltiples preguntas, se logra una mayor diversidad en las cuestiones que plantean los pacientes. La investigación analizó no solo la corrección de las respuestas, sino también los errores perjudiciales que podrían surgir, lo que es crucial para garantizar la seguridad del paciente.
Por qué es relevante
Los resultados mostraron que, aunque los modelos de lenguaje demostraron un potencial considerable para apoyar la preparación de colonoscopias, aún quedan aspectos importantes por abordar. Los modelos basados en el cierre de peso, como GPT-5.1, superaron a los modelos de peso abierto en precisión; sin embargo, todos los modelos presentaron errores perjudiciales, principalmente por omisiones o interpretaciones erróneas de las instrucciones de preparación. Además, la implementación de un filtro de seguridad automatizado mostró que, aunque se reducían las tasas de error, no eliminaba por completo las respuestas perjudiciales, lo que plantea preocupaciones sobre su uso en situaciones reales.
Lectura final
Este estudio enfatiza la necesidad de seguir mejorando en la adherencia a las instrucciones y establecer mecanismos de seguridad más robustos en la asistencia de IA. Aunque hay avances prometedores en el uso de LLMs para mejorar la experiencia del paciente en la preparación de procedimientos médicos, la falta de fiabilidad actual indica que aún no están listos para la implementación sin supervisión por parte de profesionales de la salud. Este hallazgo urge a la comunidad científica y médica a continuar investigando y validando estas herramientas para garantizar la seguridad y la efectividad en la atención al paciente.
Lectura clínica
Información editorial dirigida a profesionales de la salud. No sustituye la evaluación clínica, las guías vigentes ni el juicio médico.
Clasificación editorial automática
Fuente original
También en el radar
 Inteligencia artificial
Exhibición de mesas añadidas: Una última oportunidad para mostrar tu startup en TechCrunch Disrupt 2026
22 de septiembre de 2026 Inteligencia artificial
4 días para ahorrar hasta $200: Razón 2 de 5 para estar en TechCrunch Disrupt 2026
22 de septiembre de 2026 Inteligencia artificial
Las mesas redondas: Las mortales fallas del muro virtual
22 de septiembre de 2026 Inteligencia artificial
Liderazgo clínico debe guiar la adopción de la IA
22 de septiembre de 2026