
Escalas de riesgo en medicina: ¿aliadas confiables o falsa sensación de certeza clínica?
Resumen ejecutivo
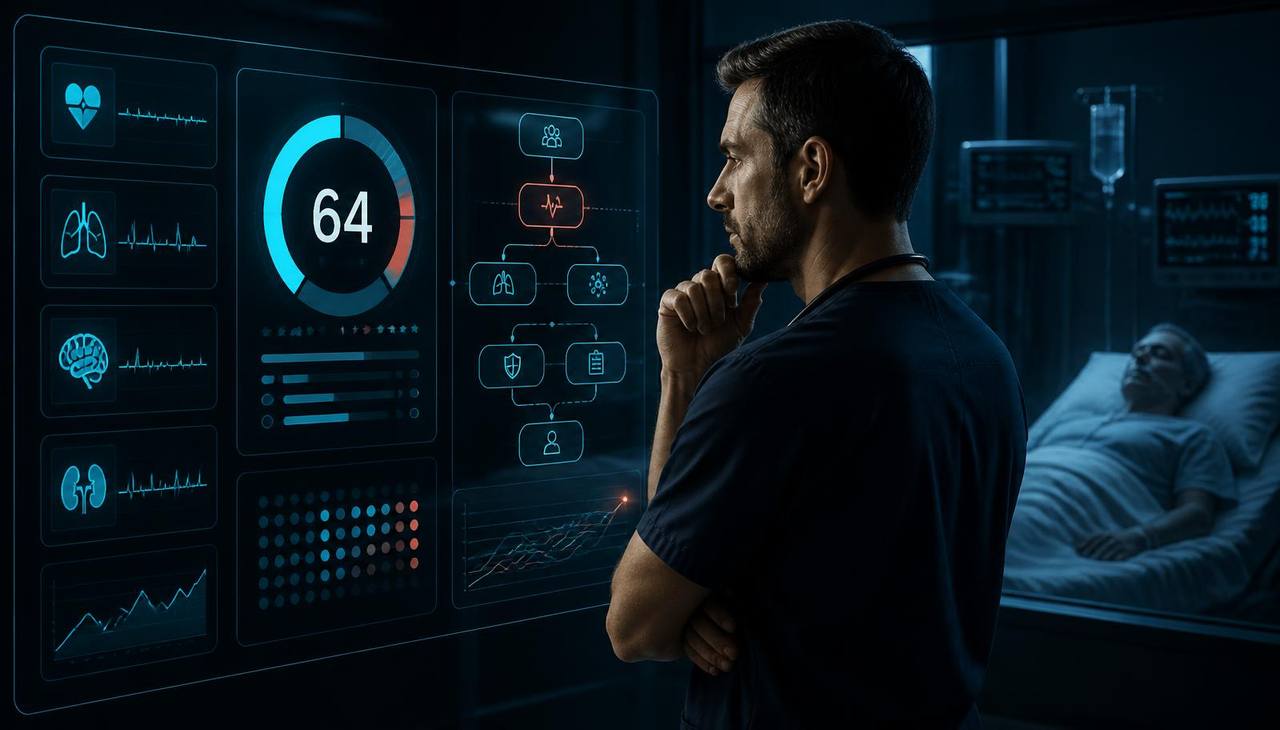
Las escalas de riesgo estandarizan el lenguaje clínico, facilitan la detección temprana del deterioro y orientan decisiones basadas en evidencia. Su principal límite es que expresan probabilidades poblacionales, no certezas individuales. Deben utilizarse con datos confiables, dentro de la población para la que fueron validadas y siempre como complemento —nunca sustituto— del razonamiento médico.
Contexto
La medicina moderna ha desarrollado, a lo largo de las últimas décadas, un arsenal impresionante de escalas y puntuaciones diseñadas para convertir la incertidumbre clínica en números. Desde el trauma hasta la falla hepática, pasando por la sepsis, el ictus y la neumonía, prácticamente no existe un escenario de urgencias o cuidados intensivos que no tenga hoy su propia herramienta de estratificación de riesgo.
El ISS y el NISS cuantifican la gravedad anatómica de un politraumatizado; el NEWS2 y el PEWS detectan el deterioro clínico antes de que sea evidente a simple vista; el SOFA y el APACHE II resumen en una cifra la disfunción orgánica de un paciente crítico; el CURB-65 ayuda a decidir si una neumonía se trata en casa o en un hospital; el CHA₂DS₂-VASc orienta la decisión de anticoagular a una persona con fibrilación auricular. La lista continúa: TRISS, RTS, MEOWS, SAPS II y SAPS 3, SMART-COP, DECAF, BAP-65, GRACE 2.0, TIMI, NIHSS, ICH Score, Glasgow-Blatchford, Glasgow-Imrie, criterios de Ranson, MELD, Child-Pugh y KDIGO.
Cada una de estas herramientas nació para resolver un problema real: la variabilidad del juicio clínico entre médicos, la necesidad de comunicar gravedad de forma rápida y objetiva y la posibilidad de predecir desenlaces con base en la evidencia acumulada de miles de pacientes. Pero su proliferación también plantea una pregunta incómoda que rara vez se discute abiertamente en la práctica diaria: ¿realmente mejoran el cuidado del paciente que tenemos enfrente o simplemente nos dan la ilusión tranquilizadora de que la medicina se ha vuelto una ciencia exacta?
Lo que estas escalas sí resuelven bien
La ventaja más evidente es la estandarización del lenguaje clínico. Cuando un médico de urgencias reporta un GRACE de 150 o un NIHSS de 22, cualquier colega entiende de inmediato la magnitud del problema sin necesidad de una narrativa extensa. Esto es particularmente valioso en los traspasos de turno, las interconsultas telefónicas y la comunicación entre niveles de atención, donde la precisión y la brevedad ahorran tiempo; y el tiempo, en medicina de urgencias, suele ser el recurso más escaso.
En segundo lugar, estas herramientas son extraordinariamente útiles para la detección temprana del deterioro, precisamente el terreno donde el ojo clínico humano puede fallar. El NEWS2 fue diseñado porque los equipos asistenciales necesitaban una manera objetiva de decidir cuándo escalar una alerta, sin depender exclusivamente de la experiencia o la intuición de quien está de turno. Lo mismo ocurre con el PEWS en pediatría y el MEOWS en obstetricia: ambas poblaciones pueden compensar fisiológicamente hasta un punto de quiebre súbito, y una alerta temprana sistemática reduce la probabilidad de que ese cambio pase inadvertido.
Un tercer punto a favor es su capacidad pronóstica basada en evidencia poblacional. El TRISS, el APACHE II o el SAPS 3 no son opiniones: nacen del análisis estadístico de decenas de miles de pacientes. Cuando se usan correctamente, permiten estimar probabilidades de supervivencia, orientar conversaciones difíciles con las familias y —algo que se subestima con frecuencia— auditar la calidad de la atención en un servicio o unidad de cuidados intensivos, comparando la mortalidad observada con la esperada según la complejidad de los casos.
Finalmente, algunas escalas cumplen una función que va más allá del pronóstico: orientan decisiones terapéuticas concretas. El CHA₂DS₂-VASc no solo estima el riesgo de ictus; su resultado participa directamente en la decisión sobre anticoagulación oral. Un GRACE superior a 140 no es un dato decorativo: puede implicar la indicación de una estrategia invasiva temprana. En estos casos, la escala no es un accesorio informativo, sino parte integral de un algoritmo de tratamiento.
Donde las escalas empiezan a mostrar sus grietas
La conveniencia de estas herramientas tiene un límite claro, y ese límite es la naturaleza misma de la estadística: una escala describe a una población, no a un paciente individual. Un SAPS 3 o un APACHE II pueden predecir con razonable precisión la mortalidad esperada de cien pacientes con características similares, pero no pueden decirle a un intensivista qué ocurrirá exactamente con una persona concreta de esa cohorte. Este matiz tiene consecuencias prácticas enormes cuando la puntuación se utiliza como sustituto del juicio clínico y no como complemento.
El propio ejemplo del SAPS 3 ilustra otro problema estructural: la necesidad de ecuaciones ajustadas por región geográfica para evitar sobreestimar la mortalidad. Muchas escalas fueron desarrolladas y validadas en poblaciones específicas, predominantemente de Norteamérica y Europa. Su transferencia directa a otros contextos, incluida buena parte de Latinoamérica, puede introducir sesgos sistemáticos si no se recalibran adecuadamente. Aplicar un CURB-65 o un DECAF sin conocer estas limitaciones puede llevar a decisiones de triaje basadas en un modelo que nunca fue validado para la población atendida.
Existe además el riesgo de una pereza cognitiva inducida por la escala: la tendencia a delegar el razonamiento clínico completo en un número, dejando de lado hallazgos atípicos que la herramienta, por diseño, no puede capturar. Un CURB-65 bajo no descarta una neumonía grave si el paciente presenta una comorbilidad o una condición no contemplada en la fórmula. Un Glasgow-Blatchford bajo tampoco elimina la necesidad de vigilancia estrecha si el cuadro global genera sospecha. Las escalas fueron construidas para reducir la variabilidad, pero cuando se usan de manera mecánica pueden reducir también el pensamiento crítico.
Otro problema, más operativo que conceptual, es la carga de tiempo y la calidad de los datos de entrada. Calcular un APACHE II completo requiere doce variables fisiológicas de las primeras 24 horas; un SOFA se recalcula de forma seriada durante la estancia en cuidados intensivos. En servicios saturados, con personal insuficiente y sistemas de información fragmentados, la recolección precisa de estas variables no siempre ocurre en tiempo real. El resultado puede ser una falsa precisión matemática construida sobre información incompleta o retrasada.
Finalmente, la redundancia y superposición entre escalas puede generar confusión en lugar de claridad. ¿Cuándo utilizar CURB-65 y cuándo SMART-COP ante una neumonía? ¿DECAF o BAP-65 para una exacerbación de EPOC cuando faltan recursos? La existencia de varias herramientas compitiendo por el mismo espacio clínico sugiere que ninguna es completamente satisfactoria y que la elección suele depender tanto de la costumbre institucional como de una superioridad demostrada de forma consistente.
Recomendaciones para el uso diario
De esta tensión entre utilidad y limitación se desprenden algunas reglas prácticas:
- Usar la escala correcta para la pregunta correcta. Un CHA₂DS₂-VASc responde a una pregunta terapéutica concreta; un APACHE II ofrece un pronóstico poblacional. Confundir ambos propósitos conduce a decisiones mal fundamentadas.
- Conocer la población en la que fue validada. Esto es especialmente importante en modelos pronósticos como SAPS 3, cuyo diseño reconoce que el origen geográfico modifica la interpretación del resultado.
- Documentar la discrepancia, no solo el número. Cuando el juicio clínico difiere de lo que sugiere la puntuación, ese desacuerdo debe quedar registrado, porque allí puede encontrarse la información más relevante.
- Revisar la calidad y el momento de los datos. Una puntuación precisa exige variables completas, actuales y correctamente medidas.
- Resistir la delegación total del razonamiento. Una escala baja no cierra el caso si la presentación clínica mantiene una duda razonable.
Una convivencia necesaria, no una sustitución
La conclusión razonable no es descartar estas escalas ni idolatrarlas, sino ubicarlas exactamente donde pertenecen: como herramientas de apoyo estructurado al juicio clínico, nunca como reemplazo de este. Funcionan mejor cuando estandarizan la comunicación, activan protocolos de alerta temprana y facilitan auditorías de calidad. Funcionan peor cuando se convierten en un ritual burocrático desconectado de la persona real o se aplican fuera del contexto poblacional para el que fueron validadas.
La próxima generación de estas herramientas probablemente ya no será estática. Los modelos de inteligencia artificial entrenados con datos longitudinales están empezando a competir con escalas como SOFA o qSOFA en la predicción temprana de sepsis, porque pueden incorporar relaciones no lineales y variables que una fórmula fija nunca capturaría.
Sin embargo, mayor capacidad predictiva no equivale automáticamente a mejor medicina. Un modelo opaco puede alcanzar una precisión estadística superior y, al mismo tiempo, resultar más difícil de auditar, explicar o cuestionar frente a un caso particular. La pregunta decisiva no es solo si la inteligencia artificial reemplazará a las escalas tradicionales, sino si podrá hacerlo preservando la transparencia, la interpretabilidad y la responsabilidad clínica que estas herramientas clásicas todavía ofrecen. Ese equilibrio entre precisión estadística y comprensibilidad clínica será uno de los campos de batalla de la próxima década en medicina de urgencias y cuidados críticos.
¿Por qué importa?
Las puntuaciones clínicas influyen en decisiones de triaje, ingreso, tratamiento, pronóstico y asignación de recursos. Usarlas fuera de contexto, con datos incompletos o como respuesta automática puede producir una falsa sensación de precisión y afectar directamente la seguridad del paciente.
¿A quién afecta?
- Salud
- Profesionales
- Investigadores
- Educación
Lectura clínica
- Análisis de expertos
- Uso clínico real
Información editorial dirigida a profesionales de la salud. No sustituye la evaluación clínica, las guías vigentes ni el juicio médico.
Clasificación editorial revisada
Radar analiza
Las escalas son una forma temprana de medicina algorítmica: convierten observaciones clínicas en reglas reproducibles. La IA promete modelos más sensibles y personalizados, pero también aumenta el riesgo de automatizar sesgos y ocultar el razonamiento. El reto no es escoger entre intuición y algoritmo, sino diseñar sistemas donde ambos se vigilen mutuamente.
Análisis editorial de Doc Deliyore
Lectura final
El valor de una escala no reside en reemplazar la incertidumbre, sino en hacerla explícita y manejable. La mejor decisión clínica aparece cuando el número estructura la conversación, pero el médico conserva la capacidad de cuestionarlo. La inteligencia artificial ampliará la predicción; su legitimidad dependerá de que no sacrifique explicabilidad ni responsabilidad.
También en el radar
 Inteligencia artificial
Exhibición de mesas añadidas: Una última oportunidad para mostrar tu startup en TechCrunch Disrupt 2026
22 de septiembre de 2026 Inteligencia artificial
4 días para ahorrar hasta $200: Razón 2 de 5 para estar en TechCrunch Disrupt 2026
22 de septiembre de 2026 Inteligencia artificial
Las mesas redondas: Las mortales fallas del muro virtual
22 de septiembre de 2026 Inteligencia artificial
Liderazgo clínico debe guiar la adopción de la IA
22 de septiembre de 2026