
Evaluación de Modelos de Lenguaje Grande para Información sobre Artroplastia Total de Rodilla en Osteoartritis de Rodilla: Desarrollo y Aplicación del Composite Clinical Reliability Score
Resumen ejecutivo
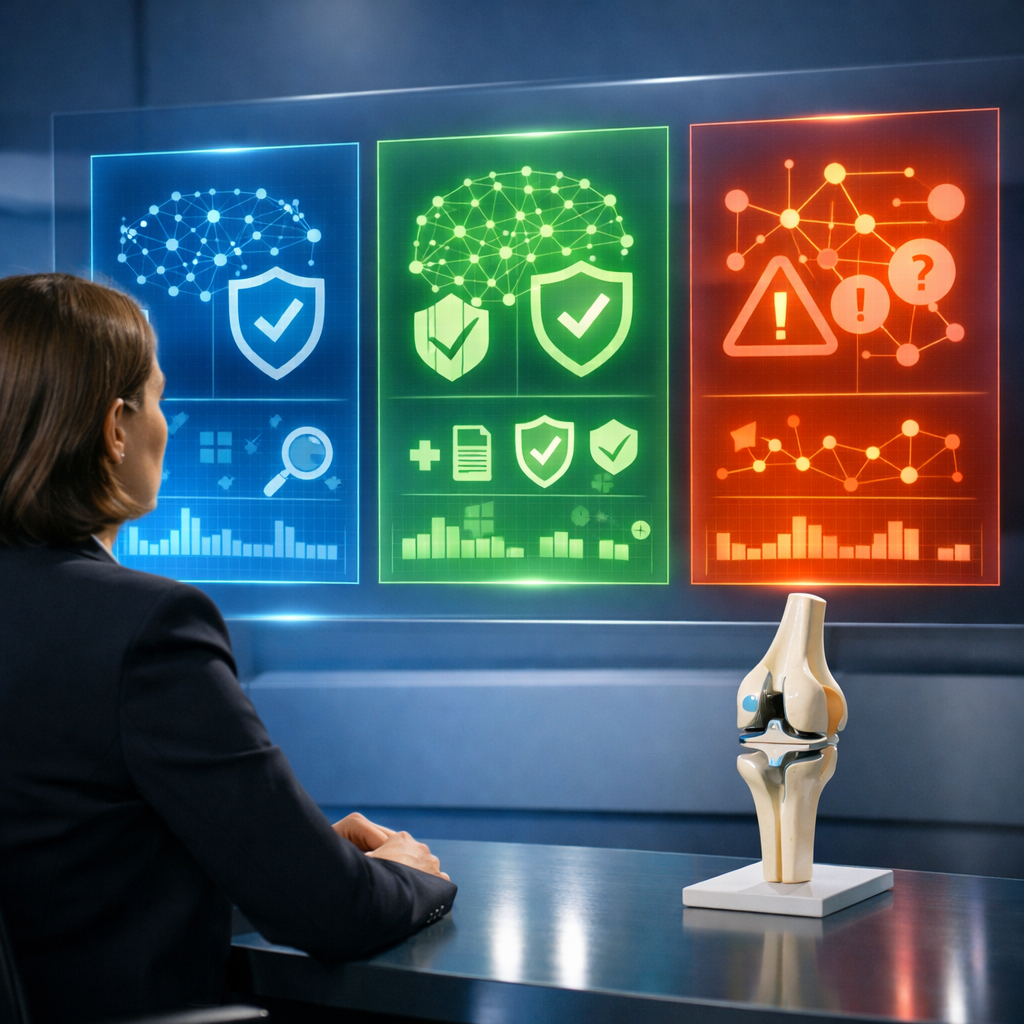
Este estudio evaluó la fiabilidad y la legibilidad de la información sobre artroplastia total de rodilla (TKA) proporcionada por tres modelos de lenguaje grande (LLMs) a partir de preguntas frecuentes de pacientes, utilizando el Composite Clinical Reliability Score (CCRS).
Qué problema aborda
La artroplastia total de rodilla es el tratamiento quirúrgico definitivo para la osteoartritis avanzada de rodilla. A medida que los pacientes recurren a los modelos de lenguaje grande para obtener orientación médica, surgen preocupaciones sobre la fiabilidad, seguridad y legibilidad de la información que reciben.
Qué hicieron los autores
Los investigadores utilizaron 90 preguntas sobre TKA extraídas de la función "People Also Ask" de Google para evaluar tres LLMs diferentes. Dos cirujanos ortopédicos entrenados evaluaron de forma independiente las respuestas generadas por los modelos en dos momentos diferentes, empleando seis dominios del CCRS: precisión fáctica, corrección clínica, adherencia a las pautas GRADE, severidad del índice de alucinación, puntuación de seguridad clínica y validez de la citación de evidencia. Además, se evaluó la legibilidad mediante el Índice Coleman-Liau, corroborado por otros índices de legibilidad.
Qué encontraron
Los resultados mostraron que el Programa 2 obtuvo la puntuación más alta en el CCRS (mediana 84.0), superando al Programa 3 (76.5) y al Programa 1 (73.0) con una diferencia estadísticamente significativa (P < 0.0001). El Programa 2 destacó en precisión, adherencia a las pautas, control de alucinaciones y en la presentación de información segura. Por otro lado, el Programa 3 mostró una mejor validez de citación de evidencia. En términos de legibilidad, el Programa 2 fue el más accesible, mientras que el Programa 3 fue el menos legible, con diferencias significativas (P < 0.0001).
Limitaciones
El estudio señala que los hallazgos son exploratorios y no deben considerarse como un ranking definitivo, dado que las salidas de los LLM son no deterministas y están en constante actualización.
Lectura final
Este estudio es relevante para los profesionales de la salud, ya que destaca la utilidad y las limitaciones de los modelos de lenguaje en la provisión de información médica a los pacientes. Aunque los LLMs pueden complementar la consulta profesional, su uso debe ser cauteloso, y su información debe ser validada por expertos en el área.
Sigue leyendo
Lectura clínica
Información editorial dirigida a profesionales de la salud. No sustituye la evaluación clínica, las guías vigentes ni el juicio médico.
Clasificación editorial automática
Fuente original
También en el radar
 Inteligencia artificial
Valve actualiza sus reglas de lanzamiento en Steam ante la avalancha de juegos de IA
4 de noviembre de 2026 Inteligencia artificial
Texas quería impulsar el auge de la IA en América. Su nuevo gobernador podría cambiarlo todo
4 de noviembre de 2026 Inteligencia artificial
Planes apresurados de Rusia para construir centros de datos subterráneos tras ataques con drones de Ucrania
3 de noviembre de 2026 Inteligencia artificial
Amazon reescribe su manual de ingeniería de software para una era en la que la IA escribe el código
3 de noviembre de 2026
¿Quieres más contexto?
Cada semana seleccionamos las señales de IA que importan, con foco en medicina.
Únete a la lista de RADAR
Te avisaremos cuando publiquemos el primer boletín y recibirás una selección breve de las señales de IA que realmente importan.