
Evaluación del rendimiento de los modelos de lenguaje grande en casos de cirugía vascular: estudio transversal
Resumen ejecutivo
Este estudio evalúa el rendimiento y la seguridad de tres modelos de lenguaje grande (LLMs) en escenarios realistas de cirugía vascular, destacando su potencial y las limitaciones éticas y de seguridad que impiden su uso clínico no supervisado.
Qué problema aborda
La creciente utilización de modelos de lenguaje grande, como ChatGPT, Gemini y Claude, por parte de los clínicos plantea interrogantes sobre su precisión, seguridad y consistencia en casos clínicos. La mayoría de los estudios previos han utilizado preguntas de opción múltiple, lo que limita la evaluación de su capacidad de razonamiento en respuestas libres.
Qué hicieron los autores
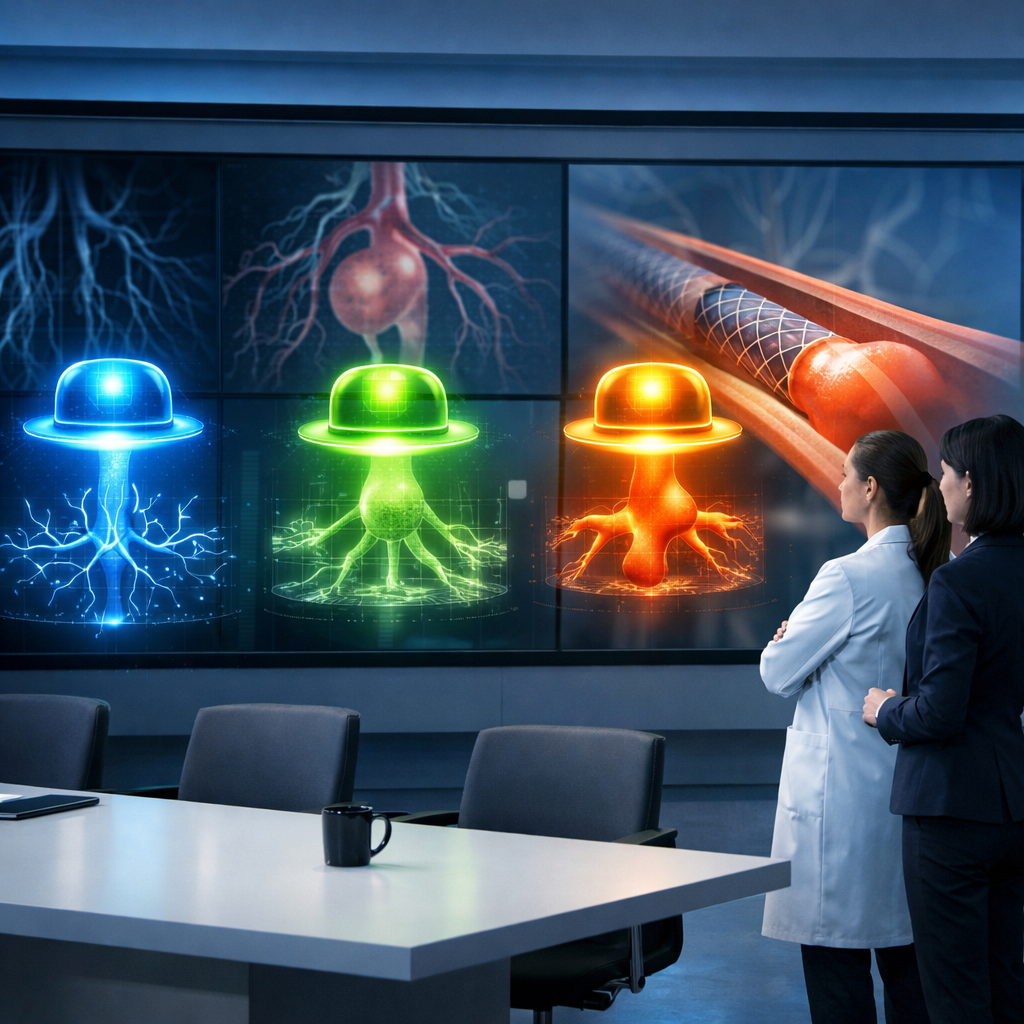
Los autores llevaron a cabo un estudio transversal donde evaluaron el rendimiento de tres LLMs en 42 casos ficticios de cirugía vascular, abarcando cinco patologías principales: isquemia aguda de miembros (ALI), aortopatía, isquemia crónica de miembros, infección del pie diabético y enfermedad cerebrovascular extracraneal. Utilizando un conjunto estandarizado de preguntas, cada modelo fue evaluado en términos de diagnóstico, investigación y manejo, tanto operativo como no operativo. Las respuestas fueron calificadas por un panel de expertos, y se realizó un análisis de seguridad de los planes generados.
Qué encontraron
Los resultados mostraron que ChatGPT obtuvo una puntuación promedio de 86.5%, Gemini 83.5%, y Claude 88.0%. Las puntuaciones variaron según la patología, siendo la isquemia aguda de miembros la que presentó la menor puntuación (82.7%). Además, se generaron planes inseguros en el 11.9% de los casos para ChatGPT, 23.8% para Gemini y 7.1% para Claude. El análisis multivariable identificó que una puntuación compuesta más baja, un mayor número de palabras en las respuestas y el caso de ALI eran predictores independientes de resultados inseguros.
Limitaciones
El estudio no detalla aspectos como el tamaño de la muestra o el método específico de evaluación utilizado, lo que limita la comprensión completa de sus hallazgos.
Lectura final
Los hallazgos de este estudio subrayan el potencial de los LLMs en la gestión de casos de cirugía vascular, aunque sus perfiles de seguridad inconsistentes y limitaciones éticas requieren una validación rigurosa antes de su integración en la práctica clínica habitual. Esto destaca la necesidad de un enfoque cauteloso en la adopción de tecnologías emergentes en medicina.
Sigue leyendo
Lectura clínica
- Información de industria
- Uso clínico real
Información editorial dirigida a profesionales de la salud. No sustituye la evaluación clínica, las guías vigentes ni el juicio médico.
Clasificación editorial automática
Fuente original
También en el radar
 Inteligencia artificial
Cómo predecir el comportamiento de las moléculas a partir de datos escasos
6 de noviembre de 2026 Inteligencia artificial
Meta abandona actualización de términos comerciales cuestionables
6 de noviembre de 2026 Inteligencia artificial
Cómo Akai y Moog están adoptando modificaciones basadas en el ambiente
6 de noviembre de 2026 Inteligencia artificial
Podrían clones de IA de GTA VI forzar un puerto oficial más rápido
6 de noviembre de 2026
¿Quieres más contexto?
Cada semana seleccionamos las señales de IA que importan, con foco en medicina.
Únete a la lista de RADAR
Te avisaremos cuando publiquemos el primer boletín y recibirás una selección breve de las señales de IA que realmente importan.