
Evidencia de que la competencia en práctica basada en evidencia media la relación entre la preparación para la IA y el juicio clínico entre enfermeras de cuidados críticos
Resumen ejecutivo
El estudio encontró asociaciones entre preparación para la IA, práctica basada en evidencia y juicio clínico autoinformado; no permite establecer causalidad
Qué problema aborda
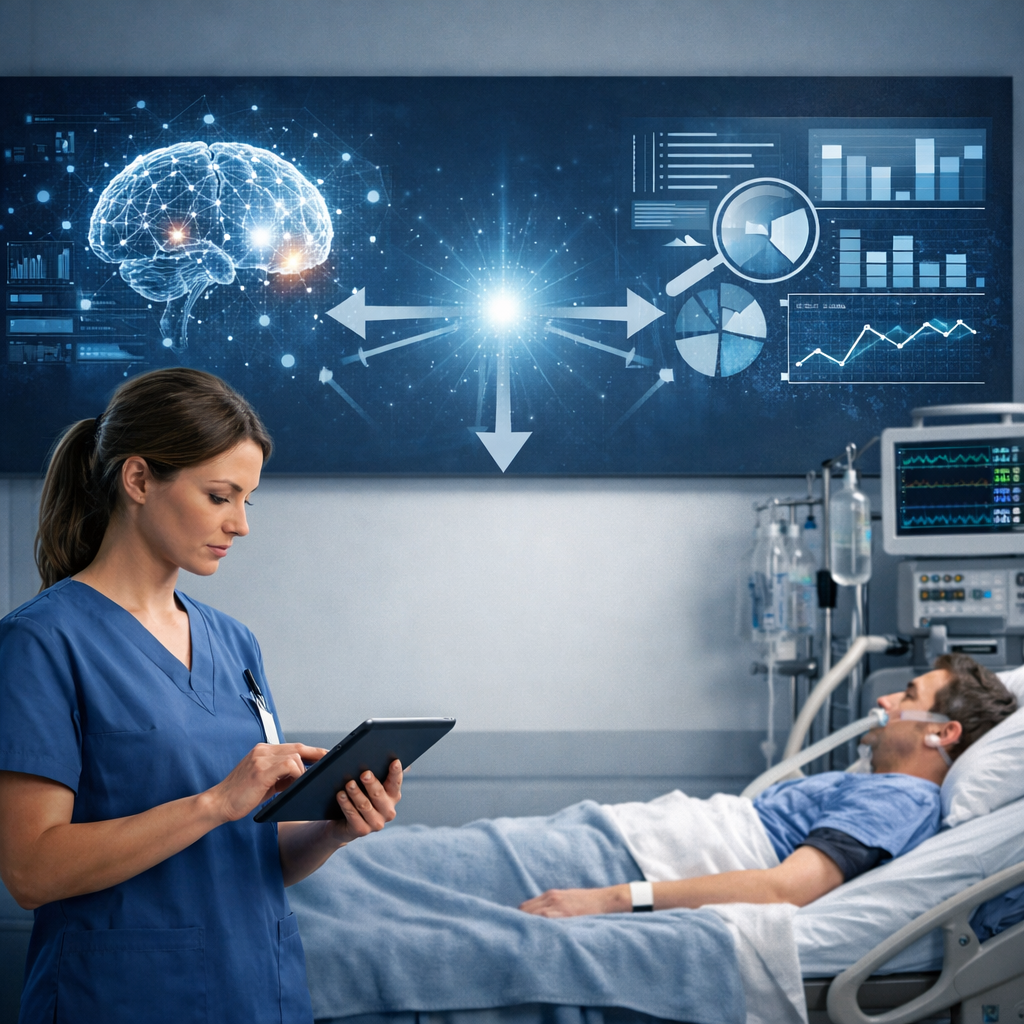
La integración de la inteligencia artificial en la práctica clínica está transformando el sector salud, especialmente en cuidados críticos, donde se requieren decisiones rápidas y complejas. La preparación de las enfermeras para utilizar la IA y su competencia en EBP son esenciales para respaldar un juicio clínico sólido.
Qué hicieron los autores
Los autores llevaron a cabo un estudio descriptivo transversal entre agosto y noviembre de 2024, involucrando a 450 enfermeras de cuidados críticos de unidades intensivas y críticas en tres hospitales universitarios gubernamentales. Se utilizaron instrumentos de auto-reporte validados para medir la preparación para la IA, la competencia en EBP y el juicio clínico. Se aplicó modelado de ecuaciones estructurales (SEM) para evaluar los efectos directos e indirectos, con índices de ajuste del modelo para evaluar su adecuación.
Qué encontraron
Los resultados revelaron que la preparación para la IA predecía significativamente el juicio clínico, tanto de manera directa (B = 0.091, p < 0.001) como indirecta a través de la competencia en EBP (B = 0.104, p < 0.001). En conjunto, la preparación para la IA y la competencia en EBP explicaron el 42.1% de la varianza total en el juicio clínico (R² = 0.421). El modelo de ecuaciones estructurales mostró índices de ajuste aceptables (CFI = 1.000, IFI = 1.000, RMSEA = 0.073).
Limitaciones
El diseño transversal del estudio y la dependencia de instrumentos de auto-reporte limitan la inferencia causal y pueden introducir sesgo de respuesta.
Lectura final
El estudio encuentra asociaciones entre preparación para la IA, competencia en práctica basada en evidencia y juicio clínico autoinformado. Su diseño transversal no permite establecer causalidad ni demostrar una mejora de la seguridad del paciente.
Sigue leyendo
Lectura clínica
Información editorial dirigida a profesionales de la salud. No sustituye la evaluación clínica, las guías vigentes ni el juicio médico.
Clasificación editorial automática
Fuente original
También en el radar
 Inteligencia artificial
 y sueño
17 de noviembre de 2026 Inteligencia artificial
 en biomateriales y bioingeniería
17 de noviembre de 2026 Inteligencia artificial
 en cirugía estética
17 de noviembre de 2026 Inteligencia artificial
Apple añade nuevos controles de disco para evitar que los agentes de IA se descontrolen
17 de noviembre de 2026
¿Quieres más contexto?
Cada semana seleccionamos las señales de IA que importan, con foco en medicina.
Únete a la lista de RADAR
Te avisaremos cuando publiquemos el primer boletín y recibirás una selección breve de las señales de IA que realmente importan.