
Google se une a OpenAI y Anthropic en el compromiso de controlar el scraping de datos
Resumen ejecutivo
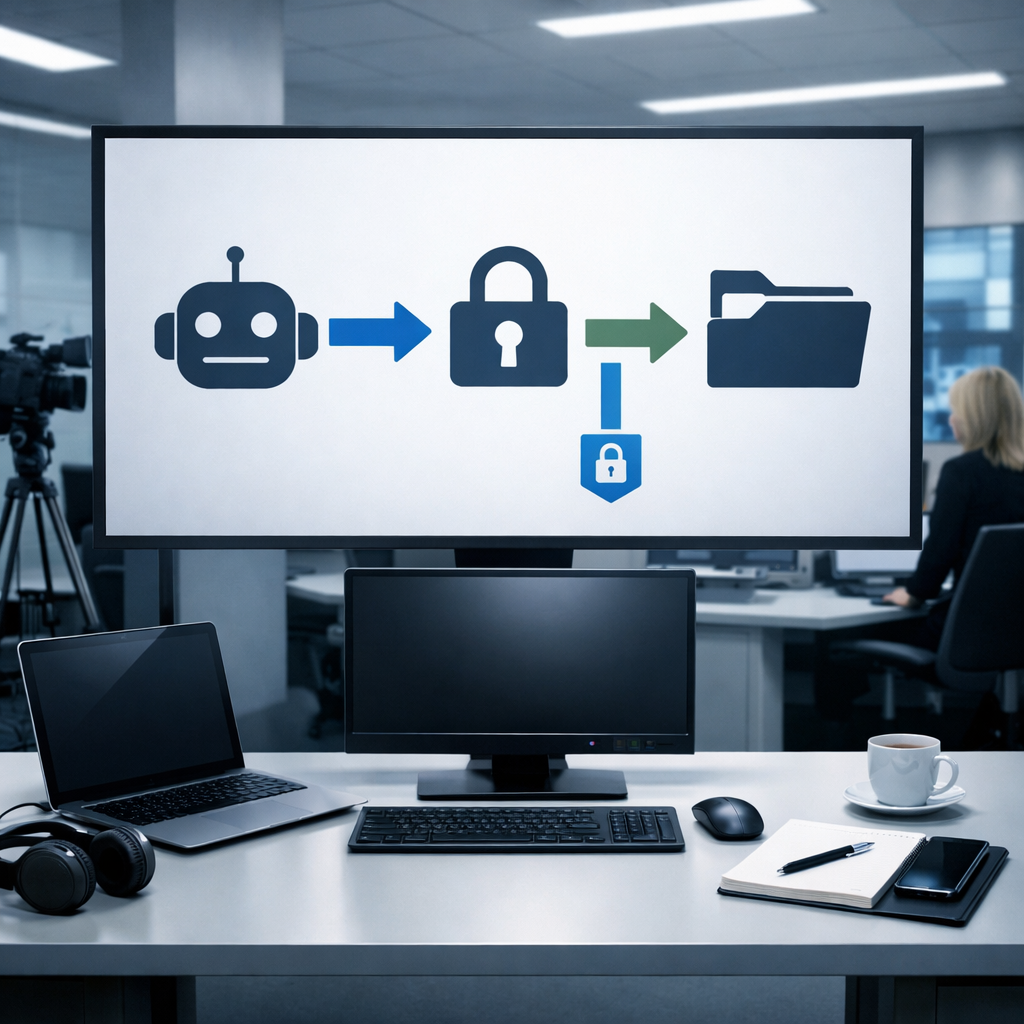
Google, OpenAI, Anthropic y Microsoft han acordado implementar un nuevo protocolo que permitirá a los editores especificar sus preferencias en cuanto al scraping de contenido para el entrenamiento de inteligencia artificial.
Qué ocurrió
Las empresas tecnológicas Google, OpenAI, Anthropic y Microsoft han decidido adoptar un nuevo directive en el archivo robots.txt que permitirá a los propietarios de sitios web controlar cómo se recopila su contenido para el entrenamiento de modelos de inteligencia artificial generativa. Este compromiso se basa en una propuesta presentada por Kevin Kelley, líder técnico de estándares de Anthropic, y está en consideración por la IETF, la organización de estándares abiertos para internet.
Los datos clave
El nuevo protocolo establece que los editores deberán incluir un nuevo agente de usuario en su archivo robots.txt, diseñado específicamente para el entrenamiento de IA. Este agente se verá de la siguiente manera:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Con esta configuración, los editores pueden bloquear a los rastreadores que buscan recopilar datos para el entrenamiento de IA, mientras que aún permiten el acceso a partes específicas de su contenido, como un kit de prensa. Sin embargo, este nuevo sistema no impide la indexación general por parte de Google, que seguirá indexando el contenido para los resultados de búsqueda.
Lo que aún no se sabe
El nuevo protocolo no tiene efecto retroactivo y no puede deshacer el scraping que las empresas ya han realizado. Esto significa que cualquier contenido que ya haya sido recopilado por estos servicios permanecerá en sus bases de datos. Además, aunque Anthropic ya ha comenzado a apoyar esta iniciativa, Microsoft planea implementarla el 1 de febrero de 2027, mientras que Google también lo hará a principios de 2027 y OpenAI en los próximos meses.
Lectura final
Este avance en el control del scraping de datos es significativo para los editores y creadores de contenido, ya que les otorga mayor autonomía sobre cómo se utiliza su información en el entrenamiento de modelos de IA. La adopción de un estándar común por parte de estas grandes empresas podría sentar un precedente importante para el futuro de la ética en la recopilación de datos y el desarrollo de inteligencia artificial.
Sigue leyendo
Fuente original
También en el radar
 Inteligencia artificial
Valve actualiza sus reglas de lanzamiento en Steam ante la avalancha de juegos de IA
4 de noviembre de 2026 Inteligencia artificial
Texas quería impulsar el auge de la IA en América. Su nuevo gobernador podría cambiarlo todo
4 de noviembre de 2026 Inteligencia artificial
Planes apresurados de Rusia para construir centros de datos subterráneos tras ataques con drones de Ucrania
3 de noviembre de 2026 Inteligencia artificial
Amazon reescribe su manual de ingeniería de software para una era en la que la IA escribe el código
3 de noviembre de 2026
¿Quieres más contexto?
Cada semana seleccionamos las señales de IA que importan, con foco en medicina.
Únete a la lista de RADAR
Te avisaremos cuando publiquemos el primer boletín y recibirás una selección breve de las señales de IA que realmente importan.