
Introducción de la inteligencia artificial en la práctica quirúrgica para el cuidado del cáncer: aplicaciones clínicas y consideraciones éticas
Resumen ejecutivo
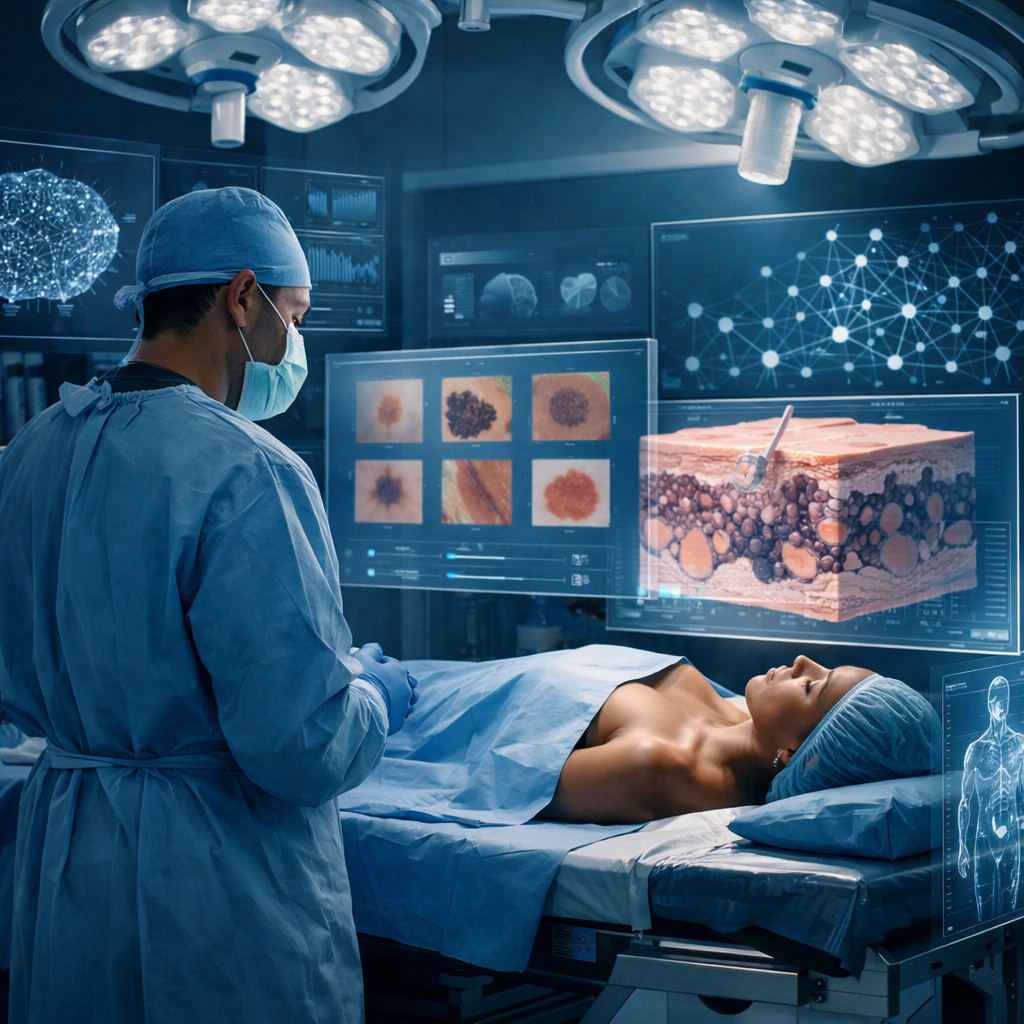
Este estudio evalúa la utilidad de modelos de lenguaje grande (LLMs) en la gestión de cirugía plástica y cáncer de piel, comparando su relevancia, precisión y representatividad clínica a través de la evaluación de respuestas generadas por cuatro LLMs.
Qué problema aborda
El uso de modelos de lenguaje grande (LLMs) en el ámbito de la salud está en aumento, pero su aplicabilidad en la cirugía plástica y el manejo del cáncer de piel aún es objeto de debate. La efectividad comparativa de estos modelos en el contexto de la cirugía de cáncer de piel no está clara, lo que genera la necesidad de una evaluación sistemática.
Qué hicieron los autores
Los autores realizaron un estudio prospectivo en el que evaluaron seis preguntas estandarizadas sobre cáncer de piel enviadas a cuatro LLMs: ChatGPT, Gemini, Claude y Copilot. Un grupo de cirujanos plásticos especializados analizó las respuestas textuales en términos de relevancia y precisión, además de generar imágenes para evaluar la representatividad y exactitud clínica. También se evaluaron la legibilidad y las puntuaciones DISCERN de las respuestas.
Qué encontraron
Los resultados mostraron que todos los LLMs produjeron respuestas textuales altamente relevantes, con puntuaciones de relevancia que oscilaron entre 4 y 5, y puntuaciones de precisión que variaron de 3 a 5. ChatGPT y Copilot alcanzaron las puntuaciones más altas en precisión individual. Solo ChatGPT y Gemini generaron imágenes, siendo ChatGPT el que demostró una mayor representatividad clínica y precisión en todas las imágenes generadas. Además, ChatGPT ofreció respuestas más complejas lingüísticamente, mientras que Copilot se destacó por la legibilidad de sus salidas. Todos los modelos generaron textos que requerían al menos un nivel educativo de secundaria. Claude obtuvo la puntuación DISCERN más alta (43.67), seguido por ChatGPT (40.33), Copilot (36.00) y Gemini (35.67).
Limitaciones
El estudio señala que las imágenes generadas mostraron predominantemente tonos de piel más claros, lo que sugiere la necesidad de una mayor inclusión de poblaciones de pacientes más diversas. Además, se menciona que los resultados deben ser utilizados junto con la revisión de un clínico, y se requiere de estudios más amplios que incluyan escenarios específicos de pacientes y tonos de piel diversos. La evaluación se limitó a seis preguntas estandarizadas y a la valoración de especialistas; no evaluó decisiones clínicas, seguridad ni resultados en pacientes.
Lectura final
Este estudio proporciona una visión exploratoria sobre la capacidad de los LLMs para generar información relevante y precisa en el contexto de la cirugía de cáncer de piel. Sin embargo, resalta la importancia de la diversidad en las salidas generadas y la necesidad de un análisis crítico por parte de los profesionales de la salud, lo que subraya la complejidad de integrar la inteligencia artificial en la práctica clínica.
Sigue leyendo
Lectura clínica
- Estudio clínico
- Investigación
Información editorial dirigida a profesionales de la salud. No sustituye la evaluación clínica, las guías vigentes ni el juicio médico.
Clasificación editorial automática
Fuente original
También en el radar
 Inteligencia artificial
 y sueño
17 de noviembre de 2026 Inteligencia artificial
 en biomateriales y bioingeniería
17 de noviembre de 2026 Inteligencia artificial
 en cirugía estética
17 de noviembre de 2026 Inteligencia artificial
Apple añade nuevos controles de disco para evitar que los agentes de IA se descontrolen
17 de noviembre de 2026
¿Quieres más contexto?
Cada semana seleccionamos las señales de IA que importan, con foco en medicina.
Únete a la lista de RADAR
Te avisaremos cuando publiquemos el primer boletín y recibirás una selección breve de las señales de IA que realmente importan.