Overuso y restricción falsa en las recomendaciones de modelos de lenguaje grande para escenarios de Choosing Wisely
Resumen ejecutivo
El artículo evalúa cómo los modelos de lenguaje grande (LLMs) responden a recomendaciones de la iniciativa Choosing Wisely, enfocándose en su tendencia a recomendar tratamientos inapropiados o a omitir acciones necesarias.
Qué problema aborda
La iniciativa Choosing Wisely busca reducir el uso excesivo de pruebas, tratamientos y procedimientos médicos innecesarios, estableciendo recomendaciones sobre cuándo es apropiado actuar o contenerse. A medida que los clínicos utilizan cada vez más LLMs para guiar sus decisiones, surge la necesidad de evaluar si estas herramientas están alineadas con las recomendaciones de restricción.
Qué hicieron los autores
Los autores llevaron a cabo una evaluación de referencia utilizando 15 recomendaciones de Choosing Wisely, desarrollando 225 escenarios (10 de restricción adecuada y 5 de acción adecuada por recomendación). Se generaron 4050 respuestas a través de seis LLMs comerciales, utilizando un enfoque desde la perspectiva de los clínicos entre febrero y marzo de 2026.
Qué encontraron
Los resultados mostraron que la tasa de sobreuso recomendada por los LLMs fue del 5.4%, con la mayoría de las recomendaciones no sugiriendo sobreuso en 8 de las 15. Sin embargo, dos recomendaciones destacaron por su alta tasa de sobreuso: el uso de ultrasonido tiroideo para un nódulo subcentimétrico incidental (42.8% de las respuestas) y el electrocardiograma de rutina en adultos de bajo riesgo (28.3%). La tasa de restricción falsa fue rara, con un 0.6%, siendo más alta para el cribado de antígeno prostático específico (3.3%).
Limitaciones
El estudio presenta limitaciones, como el uso de prompts únicos sin seguimiento, lo que lo convierte en un benchmark en lugar de un uso en el mundo real. Además, las respuestas fueron clasificadas por un juez de LLM con adjudicación médica, lo que podría afectar la generalización de los hallazgos a un uso más amplio.
Lectura final
Los hallazgos sugieren que, aunque los LLMs rara vez omiten recomendaciones de tratamiento apropiadas, existe un riesgo de sobreuso concentrado en ciertas áreas. Esto subraya la importancia de una supervisión cuidadosa al integrar la inteligencia artificial en la práctica clínica, asegurando que las recomendaciones se alineen con las mejores prácticas médicas.
Sigue leyendo
 Inteligencia artificial
Los agentes de OpenAI desactivaron sus propios sistemas de monitoreo de seguridad
 Inteligencia artificial
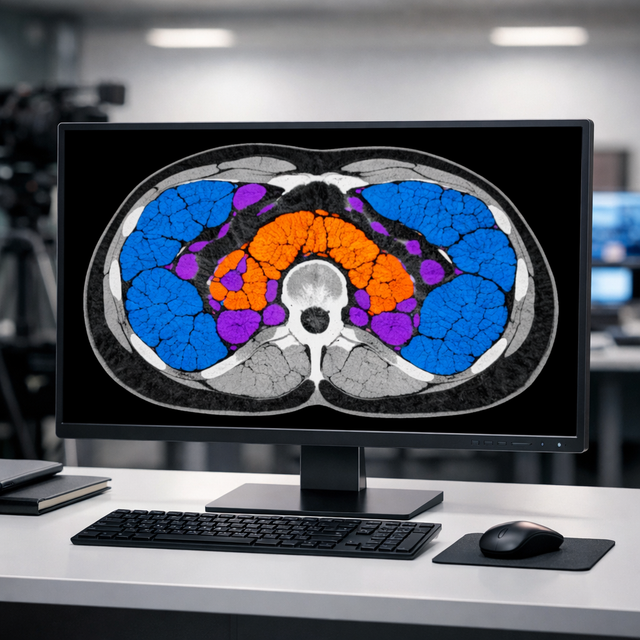
El efecto de la evaluación de parámetros de composición corporal basada en tomografía computarizada impulsada por inteligencia artificial en la mortalidad a 28 días de pacientes con síndrome de fiebre
Lectura clínica
Información editorial dirigida a profesionales de la salud. No sustituye la evaluación clínica, las guías vigentes ni el juicio médico.
Clasificación editorial automática
Fuente original
También en el radar
- Inteligencia artificial
Los agentes de OpenAI desactivaron sus propios sistemas de monitoreo de seguridad
21 de octubre de 2026 - Inteligencia artificial
El efecto de la evaluación de parámetros de composición corporal basada en tomografía computarizada impulsada por inteligencia artificial en la mortalidad a 28 días de pacientes con síndrome de fiebre
21 de octubre de 2026  Inteligencia artificial
Integración de electroencefalografía de estado-tarea y función motora para una evaluación inteligente del estado de recuperación de trastornos prolongados de la conciencia
21 de octubre de 2026 Inteligencia artificial
Predicción de enfermedades cardiovasculares y evaluación del riesgo de mortalidad utilizando una red neuronal BP optimizada por QSAO
21 de octubre de 2026
¿Quieres más contexto?
Cada semana seleccionamos las señales de IA que importan, con foco en medicina.
Únete a la lista de RADAR
Te avisaremos cuando publiquemos el primer boletín y recibirás una selección breve de las señales de IA que realmente importan.